Configuration
NVIDIA DGX Spark 128 Go
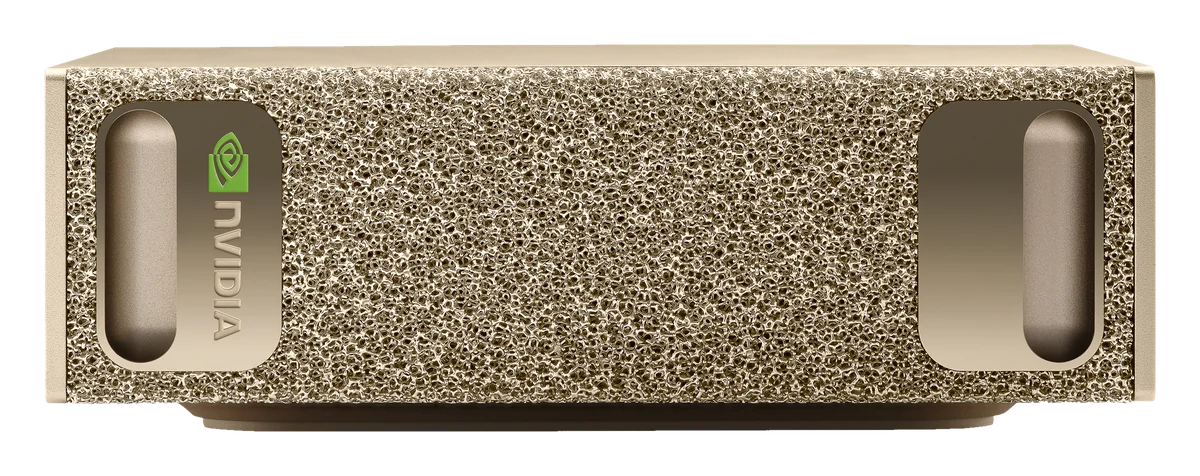
La station IA de NVIDIA, puce GB10 et 128 Go de mémoire unifiée, sur un bureau.
Station IA compacte — 150 × 150 × 50 mm, 1,2 kg
Présentation
Le NVIDIA DGX Spark est notre machine vedette : un boîtier de 15 × 15 cm qui embarque la puce GB10 Grace Blackwell et 128 Go de mémoire unifiée, partagée entre le processeur et le GPU. Il se pose sur un bureau, sans salle serveur ni climatisation.
Ses 128 Go chargent des modèles que les cartes graphiques grand public ne tiennent pas. NVIDIA annonce l'inférence de modèles jusqu'à 200 milliards de paramètres et l'affinage (fine-tuning) jusqu'à 70 milliards. Son terrain de jeu : les modèles « mélange d'experts » comme GPT-OSS-120B, rapides parce qu'ils ne lisent qu'une partie de leurs poids à chaque mot. Un modèle dense de 70 milliards de paramètres (Llama 3.3 70B) tient aussi en mémoire, mais il reste lent : à réserver à l'analyse de documents en arrière-plan.
Le tableau « Modèles, personnes en même temps, agents » plus bas donne, pour chaque modèle installable, le débit pour une personne, le nombre de personnes servies en même temps et le nombre d'agents : ce sont des estimations calculées, mesurées ensuite sur votre machine avec l'option installation.
Il fonctionne sous NVIDIA DGX OS (basé sur Ubuntu), avec CUDA et TensorRT-LLM installés ; PyTorch et vLLM s'ajoutent par les conteneurs NVIDIA. NVIDIA annonce jusqu'à quatre unités reliées par leur carte réseau ConnectX-7 à 200 Gbit/s.
Caractéristiques techniques
Cœur de calcul
- Puce
- NVIDIA GB10 Grace Blackwell (superchip)
- GPU
- Architecture Blackwell — 6 144 cœurs CUDA, Tensor 5ᵉ gén (FP4)
- CPU
- 20 cœurs Arm (10× Cortex-X925 + 10× A725)
- Puissance IA
- 1 PFLOP (1 000 TOPS) en FP4
Mémoire & stockage
- Mémoire
- 128 Go LPDDR5x unifiée (CPU + GPU)
- Bande passante
- 273 Go/s
- Modèles chargeables
- jusqu'à 200 milliards de paramètres
- Stockage
- SSD NVMe 4 To
Connectique & réseau
- Réseau haute vitesse
- ConnectX-7 200 Gbit/s (jusqu'à 4 unités reliées selon NVIDIA, fiche produit lue le 17/10/2026)
- Réseau
- 10 GbE + Wi-Fi 7 + Bluetooth 5.4
- Ports
- 4× USB-C (USB4), HDMI 2.1a
- Système
- DGX OS (basé Ubuntu), pile IA NVIDIA pré-installée
Format & consommation
- Dimensions
- 150 × 150 × 50 mm — 1,2 kg
- Alimentation
- 240 W (≈ 100–140 W en charge, 22–25 W au repos)
- Nuisance
- silencieux, aucune climatisation requise
Modèles, personnes en même temps, agents
Pour chaque modèle qui tient en mémoire : combien de personnes peuvent l'interroger en même temps en gardant chacune au moins 7 tokens par seconde (une lecture confortable, contexte de 8k), ou combien d'agents peuvent tourner seuls en même temps à 4 tokens par seconde chacun (contexte de 4k). Personnes et agents se partagent la machine : c'est l'un ou l'autre, ou un mélange des deux.
| Modèle | Mémoire (32k) | Débit pour 1 personne | Personnes en même temps | ou agents seuls | Usage |
|---|---|---|---|---|---|
| GPT-OSS-120Bconversation | ≈ 86,4 Go | 25–35 tok/s | 8 | 18 | conversation |
| GPT-OSS-20Bconversation | ≈ 17,8 Go | 40,4–57,7 tok/s | 32* | 32* | conversation |
| Mistral Small 24Bconversation | ≈ 21,1 Go | 7,9–11,3 tok/s | 4* | 4* | conversation |
| Gemma 3 27Bconversation | ≈ 25 Go | 7–10 tok/s | 2 | 4* | conversation |
| Qwen3 32Bune personne à la fois | ≈ 29 Go | 5,9–8,4 tok/s | 1, à son rythme | 4* | une personne à la fois |
| DeepSeek R1 32Bune personne à la fois | ≈ 29,7 Go | 5,9–8,4 tok/s | 1, à son rythme | 4* | une personne à la fois |
| Llama 3.3 70Blent : documents en arrière-plan | ≈ 57,2 Go | 3,1–4,3 tok/s | — | — | lent : documents en arrière-plan |
| Qwen2.5 72Blent : documents en arrière-plan | ≈ 58,6 Go | 2,7–3,8 tok/s | — | — | lent : documents en arrière-plan |
Estimations calculées, pas des mesures. Débit pour 1 personne : pré-estimation du moteur de dimensionnement. Plusieurs personnes en même temps : il faut que le moteur d'inférence soit réglé pour traiter plusieurs requêtes à la fois (par défaut, Ollama en traite une seule, les suivantes attendent leur tour). Avec l'option installation, ce réglage est fait sans supplément et vérifié au procès-verbal de recette.
Gain du traitement simultané repris de mesures publiées sur la même famille de puce (bancs de projets open source, revue technique ou résultats envoyés par des utilisateurs) : llama.cpp b7941 (05/02/2026) ; SGLang (13/10/2025). Série retenue : la plus proche du type de modèle (la plus prudente quand il y en a plusieurs), sans extrapoler au-delà du nombre de requêtes mesuré.
* Plus grand nombre de requêtes mesuré dans les sources publiées : la machine peut faire plus, ce n'est pas vérifié.
« Lent » : moins de 5 tokens par seconde pour une seule requête, utile pour analyser des documents en arrière-plan, pas pour converser. Avec l'option installation, le débit est mesuré sur votre machine et consigné au procès-verbal de recette.
Ce qui est inclus
- • Station NVIDIA DGX Spark (GB10, 128 Go, SSD 4 To) + alimentation.
- • La machine neuve, livrée en France.
- • Garanties légales prévues par les CGV et garantie du constructeur.
- • Un interlocuteur humain qui répond sous 48 h ouvrées.
- • IAboutique est un revendeur indépendant : ni fabricant ni partenaire officiel de la marque, dont les noms et logos appartiennent à leur propriétaire.
Avec l'option Installation & configuration IA
- + Installation complète sur le système de la machine (inclus, ou choisi à l'achat) : pilotes, moteur d'inférence (Ollama / vLLM), modèle choisi et interface web prête à l'emploi.
- + Débit mesuré sur votre machine, avec vos modèles, et consigné au procès-verbal de recette.
- + Prise en main à distance (1 h) et guide « premiers pas » en français.
Que faire avec cette machine
- — Interroger vos propres documents (contrats, dossiers, notes) en langage naturel : GPT-OSS-120B peut servir à plusieurs personnes d’une équipe, GPT-OSS-20B aux questions plus courantes.
- — Rédiger, reformuler, résumer et traduire des textes au quotidien, avec Mistral Small 24B ou Gemma 3 27B.
- — Servir d’assistant de programmation à une équipe technique : expliquer un projet, relire du code, écrire des scripts, avec GPT-OSS-120B.
- — Faire travailler des agents, c’est-à-dire des programmes qui enchaînent seuls des tâches (tri de courriers, comptes rendus, veille) : le tableau « Modèles, personnes en même temps, agents » en donne le nombre estimé.
- — Essayer, en plus, des outils d’images, de vidéo ou de transcription de réunions, souvent écrits pour CUDA. Ils s’installent et se testent un par un : aucun modèle de ce type n’est inclus ni promis.
Des usages possibles, pas des engagements. Les modèles cités sont ceux du tableau « Modèles, personnes en même temps, agents », dont les chiffres sont des estimations calculées.
Chargement de la fiche interactive…