Configuration
GMKtec EVO-X2 128 Go
Le niveau « cabinet » : GPT-OSS-120B et les modèles jusqu'à 70B, en local.
Mini PC IA — mémoire unifiée 128 Go
Présentation
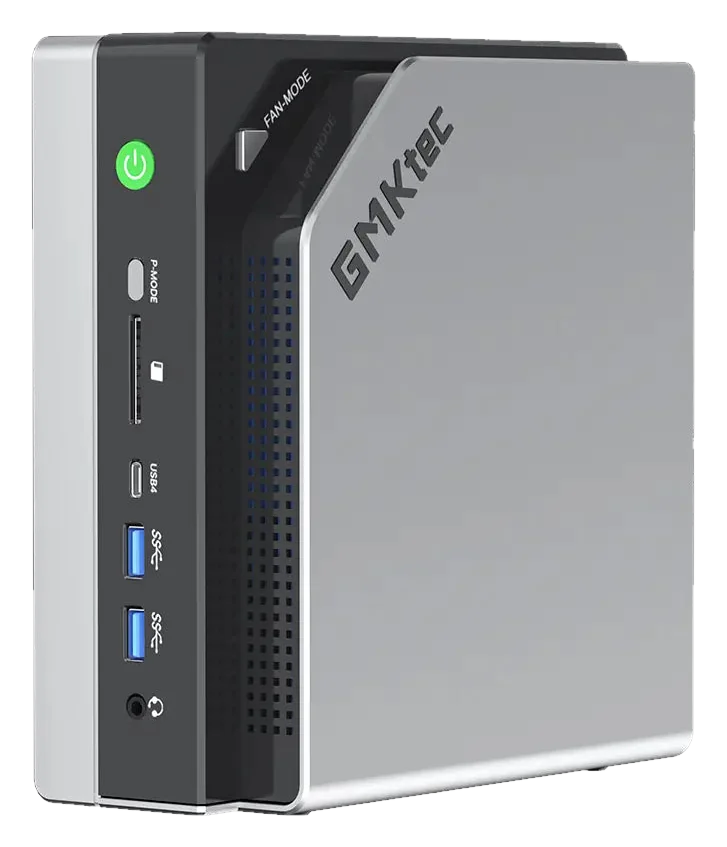
Le GMKtec EVO-X2 128 Go réunit le processeur AMD Ryzen AI Max+ 395 et 128 Go de mémoire unifiée dans un mini-PC de bureau. Les requêtes traitées en local restent sur la machine tant qu'elle n'est reliée à aucun service extérieur : pensé pour les cabinets et les métiers du secret professionnel.
Même puce et même mémoire que le Minisforum MS-S1 MAX 128 Go ; l'EVO-X2 a un port réseau 2,5 GbE (deux ports 10 GbE sur le MS-S1 MAX), pas d'emplacement PCIe, une alimentation externe et pas de montage en baie (fiches GMKtec et Minisforum, lues le 17/10/2026). Pour un poste ou un petit cabinet, ces options ne changent ni les modèles installables ni les débits estimés.
À installer en premier : un modèle « à experts » comme GPT-OSS-120B. Il compte 117 milliards de paramètres et tient dans les 128 Go, mais n'en active que 5,1 milliards par token : il écrit plus vite qu'un modèle dense, parce qu'il ne lit qu'une partie de ses poids à chaque token (fiche OpenAI, lue le 15/10/2026). Les modèles denses de 70 milliards de paramètres (Llama 3.3 70B, Qwen2.5 72B) tiennent aussi dans les 128 Go de mémoire, mais écrivent lentement sur cette puce : à réserver aux essais ou aux traitements sans attente, comme l'analyse de documents en arrière-plan.
Le tableau « Modèles, personnes en même temps, agents » donne pour chaque modèle installable le débit pour une personne, les personnes servies en même temps et les agents : estimations calculées. Aucune mesure publiée de traitement simultané trouvée sur cette puce pour les modèles proposés, au 14/10/2026 : le calcul n'en compte aucun gain, le chiffre réel peut être plus haut.
Linux ou Windows 11 Pro au choix à l'achat. Avec l'option installation : modèle installé, débit mesuré au procès-verbal de recette et sécurité durcie (chiffrement disque, pare-feu, comptes par équipe).
Caractéristiques techniques
Cœur de calcul
- Puce
- AMD Ryzen AI Max+ 395 « Strix Halo »
- CPU
- 16 cœurs / 32 threads Zen 5 (jusqu'à 5,1 GHz)
- GPU
- Radeon 8060S intégré — 40 unités de calcul RDNA 3.5
- NPU
- XDNA 2 — 50 TOPS (accélération IA)
Mémoire & stockage
- Mémoire
- 128 Go LPDDR5X-8000 unifiée (quadri-canal 256-bit)
- Bande passante
- 256 Go/s
- Modèles chargeables
- jusqu'à ~120 milliards de paramètres en modèle à experts (gpt-oss-120b) ; 70B dense en mémoire, mais lent
- Stockage
- SSD NVMe 2 To
Connectique & système
- Ports
- USB4, USB-A, HDMI 2.1, DisplayPort
- Réseau
- Ethernet 2,5 GbE + Wi-Fi
- Systèmes
- Linux administré ou Windows 11 Pro (au choix à l'achat)
- Sécurité
- chiffrement disque, pare-feu, comptes durcis (avec l'option installation)
Format & consommation
- Format
- mini-PC de bureau (moins de 3 L)
- Consommation
- ≈ 140 W en charge IA — silencieux
- Refroidissement
- dimensionné pour l'inférence en continu
Modèles, personnes en même temps, agents
Pour chaque modèle qui tient en mémoire : combien de personnes peuvent l'interroger en même temps en gardant chacune au moins 7 tokens par seconde (une lecture confortable, contexte de 8k), ou combien d'agents peuvent tourner seuls en même temps à 4 tokens par seconde chacun (contexte de 4k). Personnes et agents se partagent la machine : c'est l'un ou l'autre, ou un mélange des deux.
| Modèle | Mémoire (32k) | Débit pour 1 personne | Personnes en même temps | ou agents seuls | Usage |
|---|---|---|---|---|---|
| GPT-OSS-120Bconversation | ≈ 86,4 Go | 26,7–38,2 tok/s | 3 | 6 | conversation |
| GPT-OSS-20Bconversation | ≈ 17,8 Go | 37,9–54,1 tok/s | 5 | 9 | conversation |
| Mistral Small 24Bconversation | ≈ 21,1 Go | 7,4–10,6 tok/s | 1 | 1 | conversation |
| Gemma 3 27Bune personne à la fois | ≈ 25 Go | 6,6–9,4 tok/s | 1, à son rythme | 1 | une personne à la fois |
| Qwen3 32Bune personne à la fois | ≈ 29 Go | 6,3–8,7 tok/s | 1, à son rythme | 1 | une personne à la fois |
| DeepSeek R1 32Bune personne à la fois | ≈ 29,7 Go | 6–9 tok/s | 1, à son rythme | 1 | une personne à la fois |
| Llama 3.3 70Blent : documents en arrière-plan | ≈ 57,2 Go | 2,9–4 tok/s | — | — | lent : documents en arrière-plan |
| Qwen2.5 72Blent : documents en arrière-plan | ≈ 58,6 Go | 2,8–3,9 tok/s | — | — | lent : documents en arrière-plan |
Estimations calculées, pas des mesures. Débit pour 1 personne : pré-estimation du moteur de dimensionnement. Plusieurs personnes en même temps : il faut que le moteur d'inférence soit réglé pour traiter plusieurs requêtes à la fois (par défaut, Ollama en traite une seule, les suivantes attendent leur tour). Avec l'option installation, ce réglage est fait sans supplément et vérifié au procès-verbal de recette.
Aucune mesure publiée de traitement simultané trouvée sur cette puce pour les modèles proposés (au 14/10/2026) : le débit d'une requête est simplement partagé, aucun gain n'est compté. Le chiffre réel peut être plus haut.
« Lent » : moins de 5 tokens par seconde pour une seule requête, utile pour analyser des documents en arrière-plan, pas pour converser. Avec l'option installation, le débit est mesuré sur votre machine et consigné au procès-verbal de recette.
Ce qui est inclus
- • La machine neuve, livrée en France.
- • Garanties légales prévues par les CGV et garantie du constructeur GMKtec.
- • Un interlocuteur humain qui répond sous 48 h ouvrées.
- • IAboutique est un revendeur indépendant : ni fabricant ni partenaire officiel de la marque, dont les noms et logos appartiennent à leur propriétaire.
Avec l'option Installation & configuration IA
- + Installation complète sur le système de la machine (inclus, ou choisi à l'achat) : pilotes, moteur d'inférence (Ollama / vLLM), modèle choisi et interface web prête à l'emploi.
- + Débit mesuré sur votre machine, avec vos modèles, et consigné au procès-verbal de recette.
- + Prise en main à distance (1 h) et guide « premiers pas » en français.
- + Sécurité durcie : chiffrement disque, pare-feu, comptes par équipe.
Que faire avec cette machine
- — Interroger un gros fonds documentaire (dossiers clients, contrats, comptes rendus) avec GPT-OSS-120B, pour quelques personnes à la fois.
- — Lancer des analyses longues en arrière-plan (comparer plusieurs contrats, extraire des clauses, préparer un résumé de dossier) avec Llama 3.3 70B ou Qwen2.5 72B, plus lents : à réserver aux traitements où personne n’attend la réponse.
- — Rédiger, reformuler et traduire des courriers et des notes avec GPT-OSS-20B ou Mistral Small 24B.
- — Aider ponctuellement à la programmation (écrire un script, expliquer un fichier) avec GPT-OSS-120B.
- — Faire tourner quelques agents, c’est-à-dire des programmes qui enchaînent seuls des tâches (tri, comptes rendus) : le tableau « Modèles, personnes en même temps, agents » en donne le nombre estimé.
Des usages possibles, pas des engagements. Les modèles cités sont ceux du tableau « Modèles, personnes en même temps, agents », dont les chiffres sont des estimations calculées.
Chargement de la fiche interactive…