Configuration
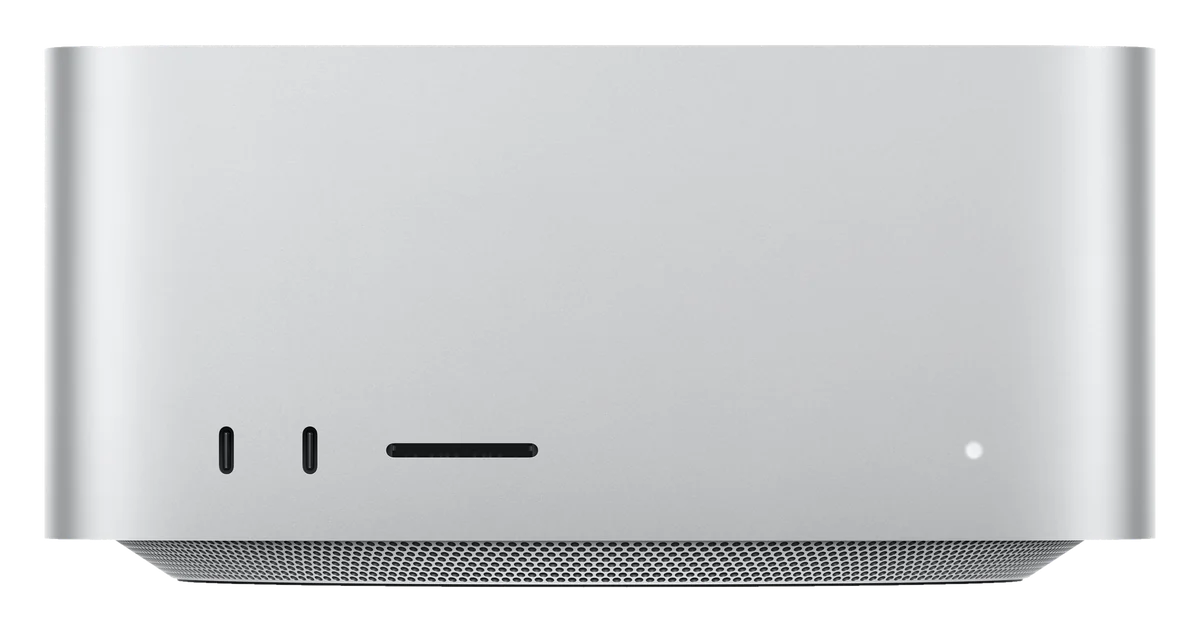
Apple Mac Studio M5 Ultra 256 Go
Puce Apple M5 Ultra, 256 Go de mémoire unifiée à 1,2 To/s, sous macOS.
Station IA compacte — 19,7 × 19,7 × 9,5 cm, 3,6 kg
Présentation
Le Mac Studio M5 Ultra réunit 256 Go de mémoire unifiée et 1,2 To/s de bande passante, plus de quatre fois les 273 Go/s de la puce GB10 de notre NVIDIA DGX Spark (données Apple et NVIDIA). Selon le calcul de notre moteur, 256 Go chargent des modèles que 128 Go ne tiennent pas, comme Qwen3 235B.
Qwen3 235B est le modèle conseillé : un « mélange d'experts » de 235 milliards de paramètres, rapide parce qu'il ne lit qu'une partie de ses poids à chaque mot. Sur cette bande passante, même un modèle dense de 70 milliards de paramètres (Llama 3.3 70B) reste utilisable en conversation.
Le tableau « Modèles, personnes en même temps, agents » donne pour chaque modèle installable le débit pour une personne, les personnes servies en même temps et les agents : estimations calculées. Aucune mesure publiée en requêtes simultanées trouvée sur la puce M5 Ultra au 14/10/2026 : le gain de traitement simultané vient de mesures sur M5 Max et M4 Max.
Il fonctionne sous macOS, avec MLX ou Ollama, sans CUDA. Sur devis : le délai Apple est constaté à la commande.
Caractéristiques techniques
Cœur de calcul
- Puce
- Apple M5 Ultra — CPU 30 cœurs, GPU 64 cœurs
- Neural Engine
- 32 cœurs
Mémoire & stockage
- Mémoire
- 256 Go unifiée (CPU + GPU)
- Bande passante
- 1,2 To/s
- Stockage
- SSD 1 To
Connectique & système
- Réseau
- 10 Gigabit Ethernet + Wi-Fi 7
- Ports
- Thunderbolt 5 : quatre ports à l'arrière, deux à l'avant
- Système
- macOS (MLX ou Ollama, sans CUDA)
Garantie
- Garantie fabricant
- 1 an : garantie commerciale Apple, aux conditions d'Apple
Format & consommation
- Dimensions
- 19,7 × 19,7 × 9,5 cm — 3,6 kg
- Consommation
- 480 W maximum en continu (donnée Apple)
Modèles, personnes en même temps, agents
Pour chaque modèle qui tient en mémoire : combien de personnes peuvent l'interroger en même temps en gardant chacune au moins 7 tokens par seconde (une lecture confortable, contexte de 8k), ou combien d'agents peuvent tourner seuls en même temps à 4 tokens par seconde chacun (contexte de 4k). Personnes et agents se partagent la machine : c'est l'un ou l'autre, ou un mélange des deux.
| Modèle | Mémoire (32k) | Débit pour 1 personne | Personnes en même temps | ou agents seuls | Usage |
|---|---|---|---|---|---|
| Qwen3 235B (MoE)conversation | ≈ 166,3 Go | 29–41,5 tok/s | 5 | 8* | conversation |
| GPT-OSS-120Bconversation | ≈ 86,4 Go | 64,2–91,7 tok/s | 8* | 8* | conversation |
| Mistral Small 24Bconversation | ≈ 21,1 Go | 34,6–49,5 tok/s | 4* | 4* | conversation |
| Gemma 3 27Bconversation | ≈ 25 Go | 30,8–44 tok/s | 4* | 4* | conversation |
| Qwen3 32Bconversation | ≈ 29 Go | 26–37,1 tok/s | 4* | 4* | conversation |
| DeepSeek R1 32Bconversation | ≈ 29,7 Go | 26–37,1 tok/s | 4* | 4* | conversation |
| Llama 3.3 70Bconversation | ≈ 57,2 Go | 11,9–17 tok/s | 2 | 4* | conversation |
| Qwen2.5 72Bconversation | ≈ 58,6 Go | 11,5–16,5 tok/s | 1 | 4* | conversation |
Estimations calculées, pas des mesures. Débit pour 1 personne : pré-estimation du moteur de dimensionnement. Plusieurs personnes en même temps : il faut que le moteur d'inférence soit réglé pour traiter plusieurs requêtes à la fois (par défaut, Ollama en traite une seule, les suivantes attendent leur tour).
Gain du traitement simultané repris de mesures publiées sur la même famille de puce (bancs de projets open source, revue technique ou résultats envoyés par des utilisateurs) : oMLX 0.3.2 (05/04/2026) ; oMLX 0.2.6 (10/03/2026). Série retenue : la plus proche du type de modèle (la plus prudente quand il y en a plusieurs), sans extrapoler au-delà du nombre de requêtes mesuré.
* Plus grand nombre de requêtes mesuré dans les sources publiées : la machine peut faire plus, ce n'est pas vérifié.
« Lent » : moins de 5 tokens par seconde pour une seule requête, utile pour analyser des documents en arrière-plan, pas pour converser.
Ce qui est inclus
- • La machine neuve, livrée en France.
- • Garanties légales prévues par les CGV et garantie du constructeur.
- • Un interlocuteur humain qui répond sous 48 h ouvrées.
- • IAboutique est un revendeur indépendant : ni fabricant ni partenaire officiel de la marque, dont les noms et logos appartiennent à leur propriétaire.
Que faire avec cette machine
- — Lancer des analyses de fond (comparer des contrats, préparer une note de synthèse) avec Qwen3 235B (MoE), le plus gros des modèles que le moteur retient pour cette machine.
- — Interroger un gros fonds documentaire (dossiers clients, contrats, comptes rendus) avec GPT-OSS-120B.
- — Rédiger, reformuler et traduire des courriers et des notes avec Mistral Small 24B ou Gemma 3 27B.
- — Analyser des dossiers longs (comparer plusieurs contrats, extraire des clauses) avec Llama 3.3 70B ou Qwen2.5 72B : le tableau « Modèles, personnes en même temps, agents » en donne le nombre estimé de personnes servies.
- — Garder l’IA sur un Mac de bureau, sous macOS : les modèles tournent avec MLX ou Ollama ; les outils écrits seulement pour CUDA ne s’y installent pas.
Des usages possibles, pas des engagements. Les modèles cités sont ceux du tableau « Modèles, personnes en même temps, agents », dont les chiffres sont des estimations calculées.
Chargement de la fiche interactive…