Configuration
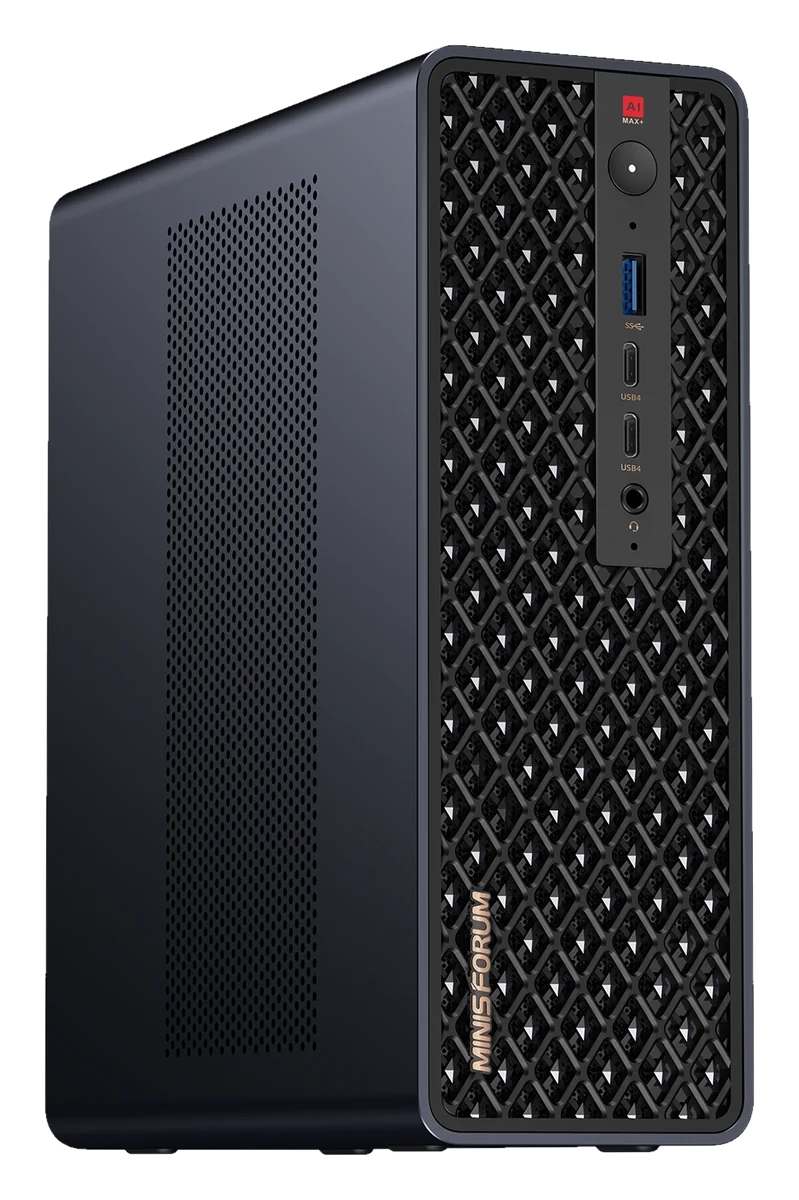
Minisforum MS-S1 MAX 128 Go
Mini-PC Ryzen AI Max+ 395, 128 Go de mémoire unifiée, double réseau 10 GbE.
Mini-PC — 222 × 206 × 77 mm, 2,8 kg, montable en rack 2U
Présentation
Le Minisforum MS-S1 MAX 128 Go reprend le processeur et la mémoire de notre GMKtec EVO-X2 128 Go : l'AMD Ryzen AI Max+ 395 avec 128 Go de mémoire unifiée. Il ajoute deux ports réseau 10 GbE, l'USB4 V2 et un emplacement PCIe pleine longueur (câblé en x4), dans un boîtier montable en baie 2U.
Par rapport à l'EVO-X2 128 Go, ces ajouts servent quand la machine rejoint un réseau rapide, une baie ou une carte d'extension ; ils ne changent ni les modèles installables ni les débits estimés.
Mêmes modèles et mêmes débits estimés que l'EVO-X2 128 Go : GPT-OSS-120B pour converser à plusieurs, et les modèles denses de 70 milliards de paramètres en mémoire mais lents, pour l'analyse de documents en arrière-plan.
Le tableau « Modèles, personnes en même temps, agents » donne pour chaque modèle installable le débit pour une personne, les personnes servies en même temps et les agents : estimations calculées, sans gain de traitement simultané compté (aucune mesure publiée trouvée sur cette puce pour les modèles proposés, au 14/10/2026).
Caractéristiques techniques
Cœur de calcul
- Puce
- AMD Ryzen AI Max+ 395 « Strix Halo »
- CPU
- 16 cœurs / 32 threads (jusqu'à 5,1 GHz)
- Puissance IA
- jusqu'à 126 TOPS (donnée fabricant)
Mémoire & stockage
- Mémoire
- 128 Go LPDDR5x-8000 unifiée
- Bande passante
- 256 Go/s
- Stockage
- SSD 2 To
Connectique & système
- Réseau
- 2 × 10 GbE + Wi-Fi 7
- Ports
- USB4 V2, emplacement PCIe pleine longueur (format x16, câblé PCIe 4.0 x4)
- Systèmes
- Windows 11 Pro préinstallé par Minisforum, ou Linux installé par nos soins (au choix à l’achat)
Format & consommation
- Dimensions
- 222 × 206 × 77 mm — 2,8 kg
- Puissance processeur
- 130 W en mode performance, 95 W équilibré, 60 W silencieux
Modèles, personnes en même temps, agents
Pour chaque modèle qui tient en mémoire : combien de personnes peuvent l'interroger en même temps en gardant chacune au moins 7 tokens par seconde (une lecture confortable, contexte de 8k), ou combien d'agents peuvent tourner seuls en même temps à 4 tokens par seconde chacun (contexte de 4k). Personnes et agents se partagent la machine : c'est l'un ou l'autre, ou un mélange des deux.
| Modèle | Mémoire (32k) | Débit pour 1 personne | Personnes en même temps | ou agents seuls | Usage |
|---|---|---|---|---|---|
| GPT-OSS-120Bconversation | ≈ 86,4 Go | 26,7–38,2 tok/s | 3 | 6 | conversation |
| GPT-OSS-20Bconversation | ≈ 17,8 Go | 37,9–54,1 tok/s | 5 | 9 | conversation |
| Mistral Small 24Bconversation | ≈ 21,1 Go | 7,4–10,6 tok/s | 1 | 1 | conversation |
| Gemma 3 27Bune personne à la fois | ≈ 25 Go | 6,6–9,4 tok/s | 1, à son rythme | 1 | une personne à la fois |
| Qwen3 32Bune personne à la fois | ≈ 29 Go | 6,3–8,7 tok/s | 1, à son rythme | 1 | une personne à la fois |
| DeepSeek R1 32Bune personne à la fois | ≈ 29,7 Go | 6–9 tok/s | 1, à son rythme | 1 | une personne à la fois |
| Llama 3.3 70Blent : documents en arrière-plan | ≈ 57,2 Go | 2,9–4 tok/s | — | — | lent : documents en arrière-plan |
| Qwen2.5 72Blent : documents en arrière-plan | ≈ 58,6 Go | 2,8–3,9 tok/s | — | — | lent : documents en arrière-plan |
Estimations calculées, pas des mesures. Débit pour 1 personne : pré-estimation du moteur de dimensionnement. Plusieurs personnes en même temps : il faut que le moteur d'inférence soit réglé pour traiter plusieurs requêtes à la fois (par défaut, Ollama en traite une seule, les suivantes attendent leur tour). Avec l'option installation, ce réglage est fait sans supplément et vérifié au procès-verbal de recette.
Aucune mesure publiée de traitement simultané trouvée sur cette puce pour les modèles proposés (au 14/10/2026) : le débit d'une requête est simplement partagé, aucun gain n'est compté. Le chiffre réel peut être plus haut.
« Lent » : moins de 5 tokens par seconde pour une seule requête, utile pour analyser des documents en arrière-plan, pas pour converser. Avec l'option installation, le débit est mesuré sur votre machine et consigné au procès-verbal de recette.
Ce qui est inclus
- • La machine neuve, livrée en France.
- • Garanties légales prévues par les CGV et garantie du constructeur.
- • Un interlocuteur humain qui répond sous 48 h ouvrées.
- • IAboutique est un revendeur indépendant : ni fabricant ni partenaire officiel de la marque, dont les noms et logos appartiennent à leur propriétaire.
Avec l'option Installation & configuration IA
- + Installation complète sur le système de la machine (inclus, ou choisi à l'achat) : pilotes, moteur d'inférence (Ollama / vLLM), modèle choisi et interface web prête à l'emploi.
- + Débit mesuré sur votre machine, avec vos modèles, et consigné au procès-verbal de recette.
- + Prise en main à distance (1 h) et guide « premiers pas » en français.
Que faire avec cette machine
- — Interroger un gros fonds documentaire (dossiers clients, contrats, comptes rendus) avec GPT-OSS-120B, pour quelques personnes à la fois.
- — Lancer des analyses longues en arrière-plan (comparer plusieurs contrats, extraire des clauses, préparer un résumé de dossier) avec Llama 3.3 70B ou Qwen2.5 72B, plus lents : à réserver aux traitements où personne n’attend la réponse.
- — Rédiger, reformuler et traduire des courriers et des notes avec GPT-OSS-20B ou Mistral Small 24B.
- — Montable en baie (format rack 2U) et reliable au réseau du bureau par ses deux ports 10 GbE : un assistant partagé pour une petite équipe.
- — Faire tourner quelques agents, c’est-à-dire des programmes qui enchaînent seuls des tâches (tri, comptes rendus) : le tableau « Modèles, personnes en même temps, agents » en donne le nombre estimé.
Des usages possibles, pas des engagements. Les modèles cités sont ceux du tableau « Modèles, personnes en même temps, agents », dont les chiffres sont des estimations calculées.
Chargement de la fiche interactive…