Configuration
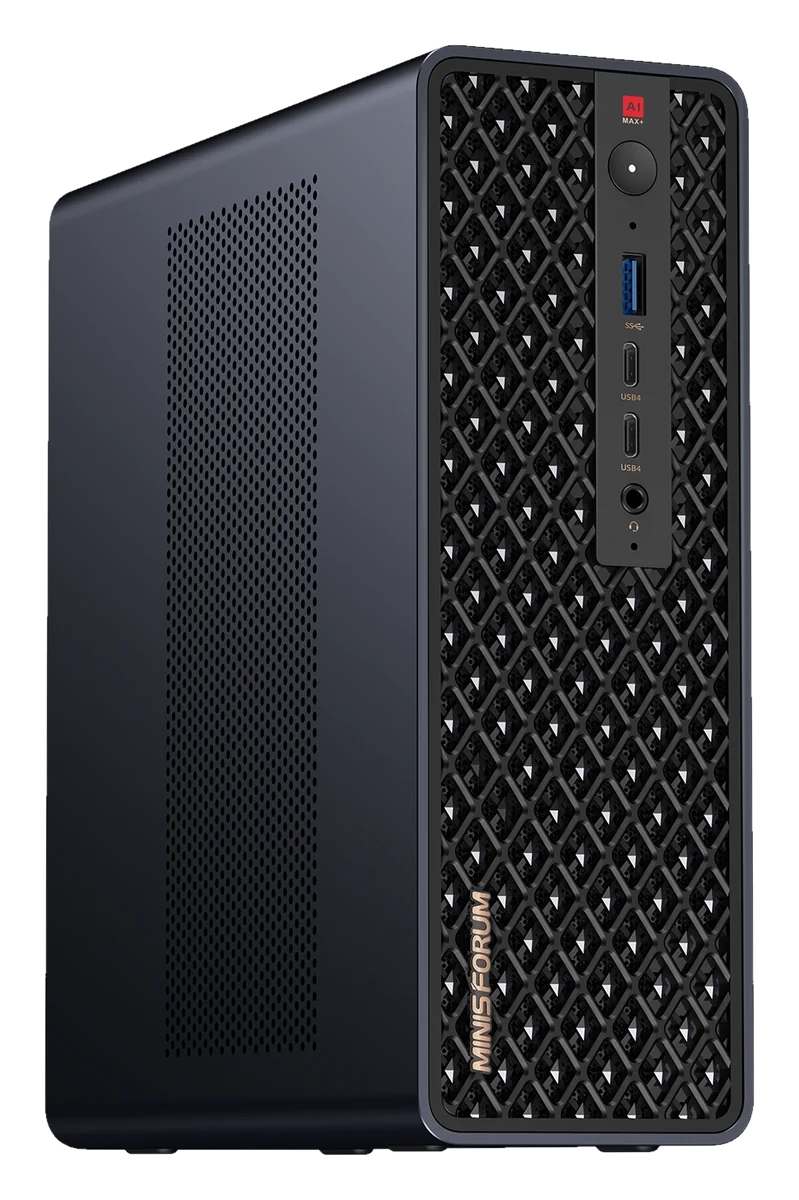
Minisforum MS-S1 MAX 64 Go
Mini-PC Ryzen AI Max+ 395, 64 Go de mémoire unifiée, double réseau 10 GbE.
Mini-PC — 222 × 206 × 77 mm, 2,8 kg, montable en rack 2U
Présentation
Le Minisforum MS-S1 MAX reprend le processeur de notre GMKtec EVO-X2 64 Go, l'AMD Ryzen AI Max+ 395, avec 64 Go de mémoire unifiée : le calibre des modèles de 20 à 32 milliards de paramètres, pour interroger vos documents en local.
Il se distingue par sa connectique : deux ports réseau 10 GbE, USB4 V2 et un emplacement PCIe pleine longueur (câblé en x4), dans un boîtier montable en baie. La mémoire est soudée : 64 Go ne pourront pas passer à 128 Go plus tard.
Mêmes modèles et mêmes débits estimés que l'EVO-X2 64 Go : GPT-OSS-20B pour servir plusieurs personnes, Mistral Small 24B et Gemma 3 27B pour une personne à la fois. Le tableau « Modèles, personnes en même temps, agents » donne les estimations calculées, sans gain de traitement simultané compté.
Caractéristiques techniques
Cœur de calcul
- Puce
- AMD Ryzen AI Max+ 395 « Strix Halo »
- CPU
- 16 cœurs / 32 threads (jusqu'à 5,1 GHz)
- Puissance IA
- jusqu'à 126 TOPS (donnée fabricant)
Mémoire & stockage
- Mémoire
- 64 Go LPDDR5x-8000 unifiée, soudée (non extensible)
- Bande passante
- 256 Go/s
- Stockage
- SSD 2 To
Connectique & système
- Réseau
- 2 × 10 GbE + Wi-Fi 7
- Ports
- USB4 V2, emplacement PCIe pleine longueur (format x16, câblé PCIe 4.0 x4)
- Systèmes
- Windows 11 Pro préinstallé par Minisforum, ou Linux installé par nos soins (au choix à l’achat)
Format & consommation
- Dimensions
- 222 × 206 × 77 mm — 2,8 kg
- Puissance processeur
- 130 W en mode performance, 95 W équilibré, 60 W silencieux
Modèles, personnes en même temps, agents
Pour chaque modèle qui tient en mémoire : combien de personnes peuvent l'interroger en même temps en gardant chacune au moins 7 tokens par seconde (une lecture confortable, contexte de 8k), ou combien d'agents peuvent tourner seuls en même temps à 4 tokens par seconde chacun (contexte de 4k). Personnes et agents se partagent la machine : c'est l'un ou l'autre, ou un mélange des deux.
| Modèle | Mémoire (32k) | Débit pour 1 personne | Personnes en même temps | ou agents seuls | Usage |
|---|---|---|---|---|---|
| GPT-OSS-20Bconversation | ≈ 17,8 Go | 25–40 tok/s | 3 | 6 | conversation |
| Mistral Small 24Bconversation | ≈ 21,1 Go | 8,5–11,7 tok/s | 1 | 2 | conversation |
| Gemma 3 27Bconversation | ≈ 25 Go | 7,5–10,3 tok/s | 1 | 1 | conversation |
| Qwen3 32Bune personne à la fois | ≈ 29 Go | 6,3–8,7 tok/s | 1, à son rythme | 1 | une personne à la fois |
| DeepSeek R1 32Bune personne à la fois | ≈ 29,7 Go | 6–9 tok/s | 1, à son rythme | 1 | une personne à la fois |
Estimations calculées, pas des mesures. Débit pour 1 personne : pré-estimation du moteur de dimensionnement. Plusieurs personnes en même temps : il faut que le moteur d'inférence soit réglé pour traiter plusieurs requêtes à la fois (par défaut, Ollama en traite une seule, les suivantes attendent leur tour). Avec l'option installation, ce réglage est fait sans supplément et vérifié au procès-verbal de recette.
Aucune mesure publiée de traitement simultané trouvée sur cette puce pour les modèles proposés (au 14/10/2026) : le débit d'une requête est simplement partagé, aucun gain n'est compté. Le chiffre réel peut être plus haut.
« Lent » : moins de 5 tokens par seconde pour une seule requête, utile pour analyser des documents en arrière-plan, pas pour converser. Avec l'option installation, le débit est mesuré sur votre machine et consigné au procès-verbal de recette.
Ce qui est inclus
- • La machine neuve, livrée en France.
- • Garanties légales prévues par les CGV et garantie du constructeur.
- • Un interlocuteur humain qui répond sous 48 h ouvrées.
- • IAboutique est un revendeur indépendant : ni fabricant ni partenaire officiel de la marque, dont les noms et logos appartiennent à leur propriétaire.
Avec l'option Installation & configuration IA
- + Installation complète sur le système de la machine (inclus, ou choisi à l'achat) : pilotes, moteur d'inférence (Ollama / vLLM), modèle choisi et interface web prête à l'emploi.
- + Débit mesuré sur votre machine, avec vos modèles, et consigné au procès-verbal de recette.
- + Prise en main à distance (1 h) et guide « premiers pas » en français.
Que faire avec cette machine
- — Interroger vos dossiers en langage naturel : retrouver une clause, comparer deux offres, résumer un dossier, avec GPT-OSS-20B.
- — Rédiger, reformuler et traduire des courriers et des notes avec Mistral Small 24B ou Gemma 3 27B.
- — Raisonner pas à pas sur un problème difficile (analyse, calcul, code) avec Qwen3 32B ou DeepSeek R1 32B, une personne à la fois, avec des réponses plus lentes.
- — Automatiser quelques tâches répétitives avec un petit nombre d’agents, c’est-à-dire de programmes qui les enchaînent seuls : le tableau « Modèles, personnes en même temps, agents » en donne le nombre estimé.
Des usages possibles, pas des engagements. Les modèles cités sont ceux du tableau « Modèles, personnes en même temps, agents », dont les chiffres sont des estimations calculées.
Chargement de la fiche interactive…